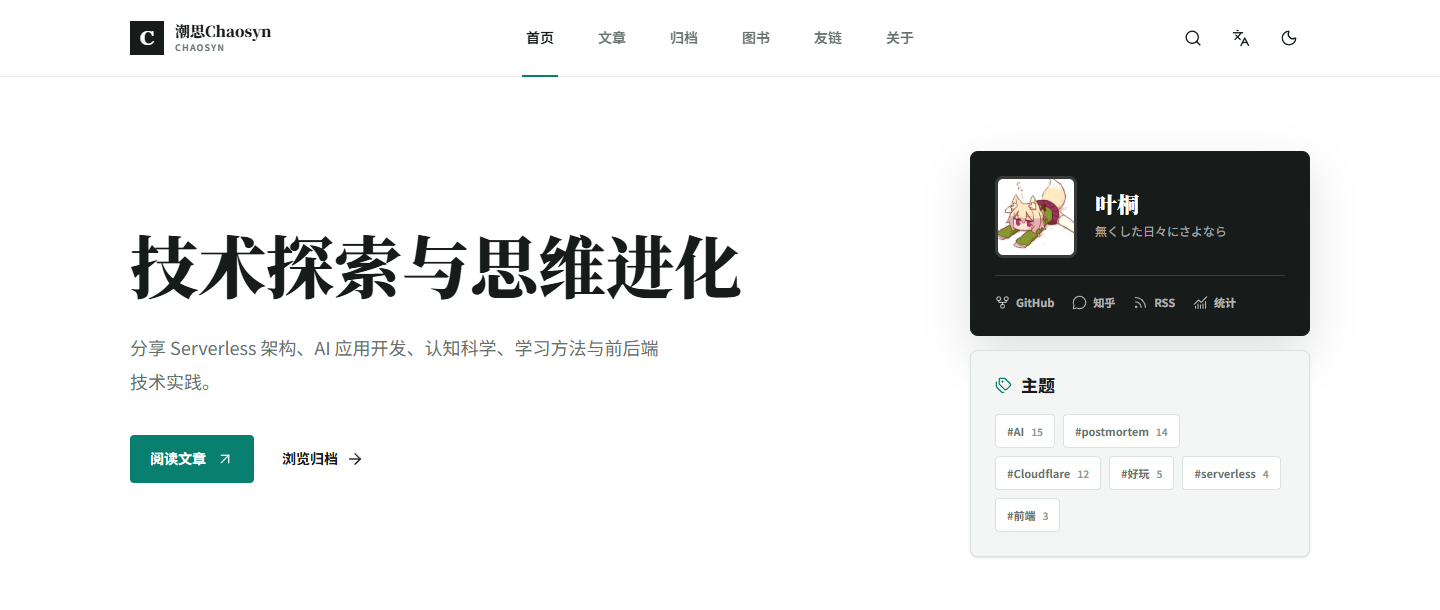
我的博客潮思 Chaosyn 从 2026 年 7 月起运行在新写的 chaosyn-blog 上,替代 3 月介绍过的 notion-fuwari。所有页面在构建时由 Next.js 16 生成为静态文件,交给 Cloudflare Pages 托管,在线运行的只有 AI 问答、友链申请和关于页数据三个接口。文章、图书和图片都放在 Git 仓库里,构建先校验内容、最后检查生成的每个页面和站内链接,任何一项不合格,这次提交就不会上线。
- 项目仓库:evepupil/chaosyn-blog
- 博客地址:blog.chaosyn.com
和 notion-fuwari 的关系
notion-fuwari 是在开源主题 Fuwari 上改出来的 Astro 站点。新站沿用了它的主要功能:Notion 同步、中英双语、图书、AI 问答和友链审核。界面先做了一版 HTML 原型确认,再用 Next.js 16、React 19、HeroUI 3 和 Tailwind CSS 4 从头实现,TypeScript 开启严格模式。
旧站内容由一个可重复执行的迁移脚本搬过来,共 33 篇文章、31 张实际引用的图片和 3 本图书(26 章)。脚本把旧字段转换成新站的严格格式,没被文章引用的图片不复制。
地址变化集中写在 redirects.config.ts,构建时生成 Cloudflare Pages 的 _redirects,旧地址一跳 301 到新地址。改了地址的有 18 篇中文文章,以及全部英文文章:旧站是 /posts/en/<slug>/,新站是 /en/posts/<slug>/。中文路径按原文写进规则时 Pages 匹配不上,上线后用冒烟脚本逐条请求旧地址才发现,生成器现在输出浏览器实际发送的百分号编码路径。
统计和广告沿用旧站的 Umami、GA4 和 AdSense 配置。文章浏览量同时查询新旧两个地址再相加,改过地址的老文章仍显示迁移前的累计数;同一个读者两个地址都访问过时,访客数会重复计入。
文章怎么进到站里
内容全部是仓库里的 Markdown/MDX 文件:文章放在 content/posts/zh/ 和 content/posts/en/,图书一本一个目录,由 index.md 和若干章节文件组成。正文按安全的 Markdown 子集渲染,不执行原始 HTML 和 MDX 组件。
文件开头的元数据(frontmatter)由 Zod 严格校验。多写一个未声明的字段、日期格式不对、标签重复、文件放错语言目录、引用的本地图片不存在,pnpm content:check 都会报出文件路径,构建随之停止。中英文两篇靠同一个 translationKey 关联,每种语言只能出现一次,语言切换按它找对应的译文。
第一个入口是 Notion。GitHub Actions 每天北京时间 0 点把已发布的页面转成 Markdown,把图片下载进仓库,校验通过后提交到 main;Cloudflare Pages 看到新提交自动构建,Action 里不存任何 Cloudflare 凭据。同步生成的文件带 source: "notion" 和 notionPageId,同步只覆盖和清理带这两个字段的文件,遇到同名的手写文章直接报错停止。文件名按 Notion 页面 ID 固定,改标题不会多出一篇。
第二个入口是直接往仓库提交。仓库里有一份给 AI 编码代理用的写作 Skill,也就是写给代理的操作说明,路径是 .agents/skills/problem-blog-writer/SKILL.md。给它真实的问题材料,它写出中英文两篇和元数据,依次跑内容校验、格式检查、lint、类型检查、单元测试和完整构建,全部通过后只提交这两篇文章和配图,推送到 main。9 月以来新增的 16 组中英文文章都是直接提交到仓库的,这篇也是用这个 Skill 发布的。
构建不通过就不发布
pnpm build 依次做这些事:从 redirects.config.ts 生成重定向规则,在 Cloudflare 上构建时检查站点地址,校验全部内容,生成中英文搜索索引,用 Next.js 静态导出到 out/,把在线接口编译进 out/_worker.js,最后用 site:check 解析 out/ 里的全部产物。
site:check 用解析器逐个读 HTML、XML 和 JSON。每个页面要有正确的 <html lang>、唯一的 canonical、当前语言的 hreflang、分享图和 Twitter Card;文章页要有能解析的 BlogPosting 结构化数据,404 页要带 noindex;页面、RSS 和 sitemap 引用的站内链接与资源都要能对应到 out/ 里的文件。Cloudflare Pages 跑的是同一个命令,构建失败的提交不会被发布,线上停在上一个版本。
这一步拦下过两次真实问题。一次是 5 篇文章里还留着 8 个指向旧地址的站内链接,那次生产构建直接失败。另一次是 Notion 定时同步把 3 个已经改好的链接写回了旧地址;之后同步脚本先用 redirects.config.ts 同一份映射把正文里的旧链接改成新地址,再写入文件。
GitHub Actions 在每个 PR 和 main 的每次提交上跑格式、lint、类型检查、单元测试、Playwright 端到端测试和完整构建。端到端测试直接打开静态导出的产物,不依赖开发服务器。
站点地址有一个部署细节。Cloudflare 项目里保存了 NEXT_PUBLIC_SITE_URL,但这个项目的 Git 构建日志显示变量没有进入构建进程,所以正式域名直接写在 Pages 的构建命令里。构建脚本检测到 CF_PAGES=1 时,会拒绝缺失、非 HTTPS、localhost 和 example.com 的地址,防止 canonical、RSS 和 sitemap 带着错误域名上线。
静态页面和三个在线接口
所有页面在构建时生成,部署产物就是 out/ 目录,不需要 Node.js 常驻进程。站内链接统一关掉了 Next.js 的自动预取:Next.js 16 静态导出后,预取请求的文件路径和 out/ 里的实际文件对不上,纯静态托管会返回 404。
三个在线接口放在 functions/api/。Pages 的 Git 上传阶段没有稳定识别源码里的 functions/ 目录,构建脚本就把它们打包成单个 out/_worker.js,也就是 Pages 的高级模式;_routes.json 只把 /api/* 交给它,文章和静态资源由 Pages 直接返回。
评论用 Giscus,统计用 Umami、Cloudflare Web Analytics 和 GA4,广告用 AdSense。每一项都能在 site.config.ts 里单独关掉,关掉后不加载对应脚本,广告位连占位都不渲染。统计和广告脚本最初用 next/script 加载,上线后在浏览器里检查发现,静态导出页面里的这些标签带着 inert 属性,脚本没有执行;现在统一等页面在浏览器里接管(hydration)之后,再用 JavaScript 插入。
评论区进入视口上下 600 像素范围才连接 giscus.app,15 秒内没加载出来就显示重试按钮。关闭 JavaScript 后,站内链接、文章正文和图书章节照样能读,Playwright 有对应的用例。
中英文双语
中文页面在根路径,英文在 /en/ 下。两种语言各用一个根布局,静态 HTML 里的 <html lang> 不用等 JavaScript 就是对的。
语言切换先找同一个 translationKey 的译文,没有译文就回到目标语言首页。缺失的 /en/* 地址显示英文 404:构建时额外放一份 out/en/404.html,Pages 会沿请求路径逐级向上找最近的 404.html。搜索索引和 RSS 也按语言分开生成。
站内搜索和 AI 问答
普通搜索用 MiniSearch。索引在构建时按语言生成,第一次打开搜索框时才并行下载搜索库和当前语言的索引,平时读文章不加载。中文按单个汉字切词,英文按单词切词;所有词都命中才算结果,支持前缀匹配,5 个字符及以上的词容许少量拼写错误。
AI 问答用 Cloudflare AutoRAG(现已改名 AI Search),项目用的是旧版 env.AI.autorag() 绑定。这个项目流式调用 aiSearch() 时,拿到的来源列表可能一直为空,所以接口分两步:先用 search() 检索,经 BGE 模型重排后保留分数达标、能对应到站内页面的结果,最多 5 条;一条可靠结果都没有就直接返回“无引用”,不调用生成模型;有结果才调用 aiSearch(),由 Llama 3.3 70B 生成回答,回答和引用通过 SSE 流式返回。部分概览类问题的结果会被重排模型全部过滤,这时改用关闭重排、门槛 0.5 的向量检索兜底。
限流放在 D1:每个来源每分钟 6 次,全站每分钟 30 次,两个计数在同一批 SQL 里原子更新。Pages Functions 的绑定里没有 Workers 的 Rate Limiting;KV 是最终一致的,跨地域并发自增会互相覆盖。接口不记录问题原文、IP 和回答,用户计数键是按天轮换的哈希。
关于页、友链和 llms.txt
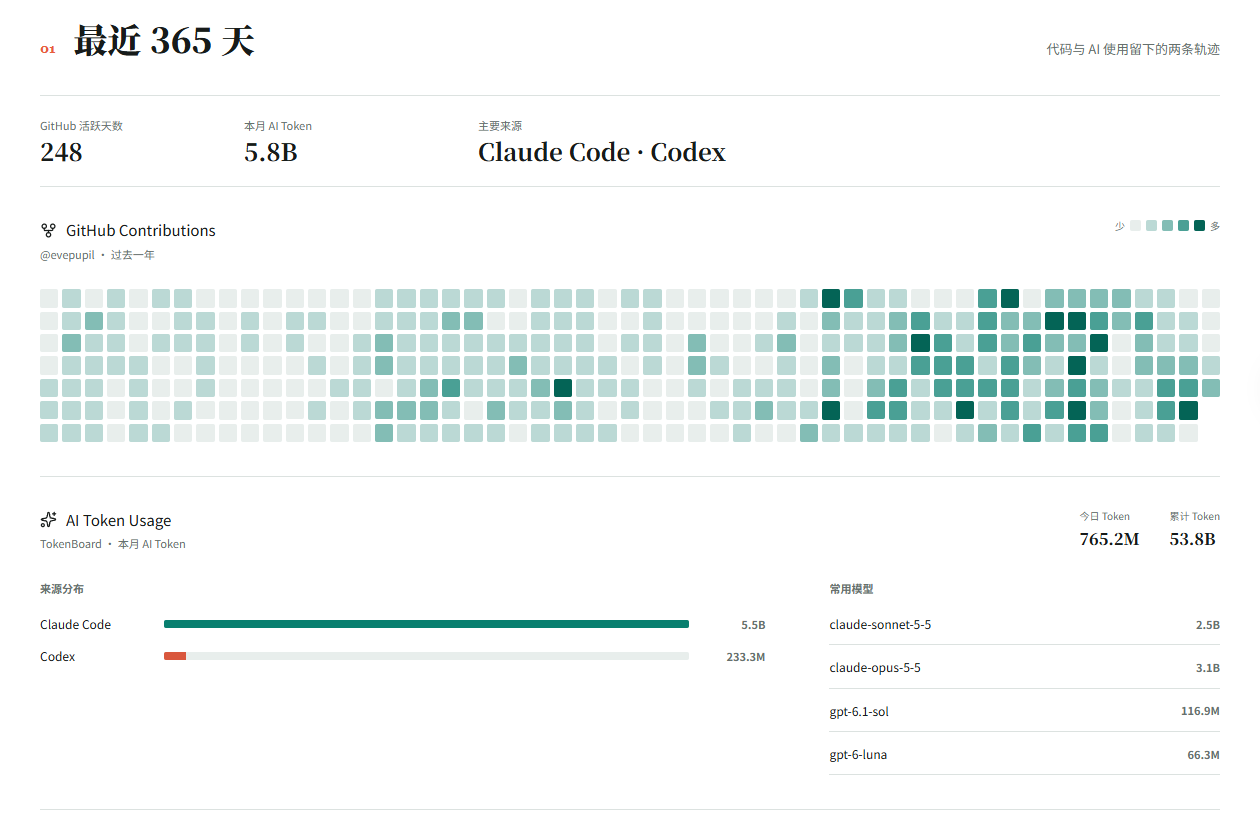
关于页只展示能公开核对的数据。GitHub 贡献日历和 TokenBoard 的 AI Token 用量由 /api/about-status 并行读取,各自 8 秒超时、缓存 30 分钟,一个来源失败不影响另一个。GitHub 部分解析公开贡献页的 HTML,读不到精确数字就整块标为不可用,不显示估算值;TokenBoard 返回的费用和缓存字段在接口里丢弃,不会传到浏览器。微信读书由另一个 Action 每天北京时间 0 点 30 分通过官方接口同步,只保留最近 3 本公开书籍,私密书籍和接口密钥不进仓库。技术雷达直接写在 site.config.ts 里。
友链申请由 /api/submit-friend-link 接收:校验来源、字段和 HTTPS 地址,经 D1 限流后在 Notion 友链库里建一条“待审核”记录。管理员在 Notion 里改成“已通过”,每天的同步再把它写进 data/friends.json、下载头像,下一次构建后出现在友链页。接口不直接改仓库,公开列表的每次变化都有提交记录,可以回滚。
根目录的 llms.txt 在构建时从已发布内容生成,按语言列出文章、图书和站点入口,供支持这个约定的 AI 工具读取,草稿不会进入。
如果你也想用
本地运行需要 Node.js 22.14 和 pnpm 10.21:
git clone https://github.com/evepupil/chaosyn-blog.git
cd chaosyn-blog
corepack enable
pnpm install --frozen-lockfile
cp .env.example .env.local
pnpm dev
换成自己的站点,主要改四处:site.config.ts 里的站点名、作者、社交链接和各项集成开关;public/images/ 里的头像、分享图和赞赏码;wrangler.jsonc 里的 Pages 项目名和 D1 数据库;正式域名。site.config.ts 会进入浏览器产物,Notion Token、微信读书 Key 这类密钥只能放在 .env.local 和部署平台的 Secret 里。
Cloudflare Pages 关联 GitHub 仓库后,构建命令写 NEXT_PUBLIC_SITE_URL=https://你的域名 pnpm build,输出目录填 out,Node.js 和 pnpm 选和本地相同的版本。外部服务都是可选的:Notion 同步缺少密钥时会报错退出,不用 Notion 就在 GitHub 里停用这个定时任务;微信读书缺 Key 会自动跳过;AI 问答和友链申请缺少绑定或密钥时接口返回 503,文章阅读不受影响。
读代码可以按这个顺序:lib/content/ 看内容格式和查询,scripts/ 看构建、同步和检查脚本,functions/api/ 看三个在线接口。docs/roadmap.md 和 docs/模块设计/ 记着每个模块的设计决策和改动原因。
参考资料
- evepupil/chaosyn-blog
- Next.js:Static Exports
- Cloudflare Pages:Advanced mode
- Cloudflare Pages:Functions routing
- Cloudflare Pages:Redirects
- Cloudflare Pages:Serving Pages
- Cloudflare Pages:Functions bindings
- Cloudflare KV:How KV works
- Cloudflare AI Search:Workers binding (legacy)
- MiniSearch
- giscus
- llms.txt
- 站内:开源自用的博客系统notion-fuwari
喜欢这篇文章?
如果这篇文章帮到了你,可以请我喝杯咖啡,支持我继续写下去。
评论